Toda segunda-feira, a analista de qualidade sorteia alguns tickets de cada atendente, abre a planilha de monitoria e começa a preencher: cumprimentou, entendeu o pedido, resolveu, encerrou direito. No fim do mês, cada atendente recebe uma nota e uma devolutiva. A avaliação de atendimento feita assim é o instrumento mais antigo de qualidade em suporte, e continua útil. Mas ela tem dois pontos fracos que quase ninguém discute: o formulário costuma medir a coisa errada, e a amostra é pequena demais para enxergar o que importa.
Este texto mostra um exemplo de formulário que funciona, como calcular a nota sem se enganar, e o que fazer com o que a amostra não alcança.
O que a avaliação de atendimento mede (e o que ela não mede) #
A monitoria é a régua da empresa sobre a conduta do atendimento. O CSAT é a régua do cliente sobre a experiência inteira. As duas parecem medir a mesma coisa e não medem.
O cliente que dá nota 1 porque a política de reembolso é ruim pode ter sido atendido de forma impecável. E o cliente que dá nota 5 pode ter recebido uma informação errada que só vai descobrir semana que vem. Por isso a avaliação de atendimento não deve copiar o CSAT, nem ser calibrada para “bater” com ele. Ela responde a outra pergunta: o atendente fez o que a operação espera que ele faça? (Os dois números, e outros, aparecem lado a lado em indicadores de atendimento.)
Também não é o lugar de medir o motivo do contato. Se a fila está cheia de cobrança duplicada, nenhuma nota de monitoria vai mudar isso. Esse é o trabalho de mapear motivos de contato, e não de avaliar quem atendeu.
Exemplo de avaliação de atendimento #
O erro mais comum é o formulário de escala: “cordialidade, de 1 a 5”, “clareza, de 1 a 5”. Duas avaliadoras olham o mesmo ticket e uma dá 3, a outra dá 4, e nenhuma das duas está errada. A nota final vira média de impressões.
Perguntas fechadas, que se respondem com sim, não ou não se aplica, resolvem quase todo esse problema. Cada pergunta descreve um comportamento que dá para apontar no texto. Um exemplo de formulário para atendimento por chat ou ticket, em três blocos:
Resolução
- O atendimento respondeu a todas as perguntas explícitas do cliente?
- A informação passada estava correta, segundo o procedimento vigente?
- Quando não resolveu na hora, disse o próximo passo e o prazo?
- O caso foi encaminhado para a fila certa, se precisou de outra área?
Experiência
- O atendimento demonstrou ter entendido o pedido antes de responder?
- Evitou pedir ao cliente uma informação que ele já tinha dado?
- A linguagem foi clara, sem jargão interno nem resposta pronta fora de contexto?
- O encerramento foi sinalizado, em vez de a conversa simplesmente parar?
Conduta
- Tratou o cliente com respeito do início ao fim?
- Pediu e usou dados pessoais só quando eram necessários?
- Evitou prometer o que não podia cumprir (estorno, prazo, exceção)?
A pergunta 4 não se aplica a um ticket resolvido na primeira resposta. A pergunta 3 não se aplica quando o problema foi resolvido. Por isso a opção “não se aplica” é obrigatória, e não um detalhe: sem ela, a avaliadora é forçada a dar “sim” de cortesia ou “não” injusto.
Adapte as perguntas ao seu procedimento, mas mantenha a regra: se duas pessoas não conseguem concordar sobre a resposta lendo o mesmo ticket, a pergunta está mal escrita.
Quebras não entram na média #
Algumas falhas não são uma pergunta reprovada entre onze. Expor dado de outro cliente, ofender, prometer uma condição que a empresa não oferece. Se essas falhas entrarem na média, um atendimento grave pode sair com nota 90 porque o resto estava em ordem.
Trate essas perguntas como quebra: elas não somam pontos, elas marcam o ticket. Ticket com quebra vai para revisão no mesmo dia, independentemente da nota.
Como calcular a nota da monitoria #
Com perguntas fechadas, a conta é simples:
Nota = respostas “sim” ÷ perguntas aplicáveis × 100
As perguntas marcadas como “não se aplica” saem do numerador e do denominador. Um ticket com 9 perguntas aplicáveis e 8 “sim” fica com 89. Outro com 6 aplicáveis e 6 “sim” fica com 100, e está certo: ninguém foi punido por não ter precisado encaminhar o caso.
Dá para dar peso diferente aos blocos, se a operação considera Resolução mais importante que Experiência. Só não esconda o peso: quem recebe a nota precisa conseguir refazer a conta.
A média do atendente por mês é o número que todo mundo pede, e o menos útil. Mais útil é olhar a taxa de reprovação de cada pergunta: em quantos tickets ela se aplicou e em quantos falhou. Se a pergunta 8 reprova em um de cada cinco tickets do time inteiro, o problema não é um atendente, é o procedimento de encerramento, ou a ferramenta que fecha o ticket sozinha depois de um tempo sem resposta.
Calibração: a mesma régua para todos #
Quando há mais de uma pessoa avaliando, as notas divergem mesmo com perguntas fechadas. A calibração é o ritual que mantém a régua única:
- Uma vez por mês, todas as avaliadoras avaliam os mesmos cinco tickets, sem combinar.
- Na reunião, comparem pergunta por pergunta. Onde houve discordância, discuta o ticket, não a pessoa.
- Registre a decisão como exemplo ao lado da pergunta (“encerramento com ‘qualquer coisa estou à disposição’ conta como sinalizado”).
- Se uma pergunta gera discordância todo mês, reescreva a pergunta.
Inclua um supervisor de fila de vez em quando. Ele costuma apontar regras de procedimento que a qualidade nem sabia que tinham mudado.
O limite da amostra #
Esta é a parte que o formulário não resolve. Uma operação com 20 mil tickets por mês e duas pessoas de qualidade, cada uma avaliando uns 25 tickets por dia, chega a cerca de mil tickets avaliados no mês (os números são hipotéticos). É 5% do volume, e já é uma operação de qualidade bem montada. Muitas avaliam menos de 2%.
Com essa amostra, três coisas ficam difíceis:
- O que é raro. Uma quebra de conduta que acontece em 0,3% dos tickets aparece em três avaliações por mês, se a sorte ajudar. Os casos que mais importam são justamente os que a amostra menos encontra.
- O atendente. Dez tickets por atendente no mês dão uma nota que oscila muito com um único ticket ruim. A devolutiva vira discussão sobre aquele ticket, e não sobre um padrão.
- O cruzamento. A pergunta “o encerramento falha mais em algum motivo de contato?” precisa de volume em cada motivo. Mil tickets espalhados por trinta motivos não sustentam essa leitura.
E o sorteio raramente é sorteio. A avaliadora pula o ticket de quarenta mensagens porque leva meia hora, e a amostra fica enviesada para os atendimentos curtos, que são os mais fáceis.
A saída tradicional é contratar mais gente para a qualidade. A outra é mudar o papel da monitoria: em vez de achar os problemas, ela confirma e aprofunda os problemas que uma leitura completa já apontou.
Devolutiva que muda comportamento #
Qualquer que seja o tamanho da amostra, a avaliação só vale se voltar ao atendente de um jeito que ele consiga usar:
- Mostre o trecho. “Reprovou em entendimento do pedido” não ensina nada. A mensagem do cliente e a resposta dada, lado a lado, ensinam.
- Separe pessoa de processo. Se a mesma pergunta reprova no time todo, a devolutiva é para quem escreveu o procedimento.
- Comece pelo que se repete. Um padrão em vários tickets vale mais do que o pior ticket do mês.
- Deixe o atendente contestar. Uma resposta corrigida depois da conversa é sinal de que a pergunta ou o exemplo da calibração precisam de ajuste.
Onde o Echo entra #
O Módulo Echo, da plataforma Kairos, se conecta ao helpdesk e lê todos os atendimentos finalizados, não uma amostra. Para cada ticket, ele escreve um resumo do que aconteceu e responde perguntas fechadas sobre Resolução, Experiência e Conduta, no mesmo espírito do formulário acima. Pergunta que não se aplica ao ticket sai da conta.
A nota do ticket, de 0 a 100, é somada dessas respostas. Não é um número que o modelo inventa, e serve para orientar a investigação, não para substituir o julgamento de quem faz a qualidade. Quando o gestor discorda de uma resposta, ele corrige, e a correção sobrevive ao reprocessamento.
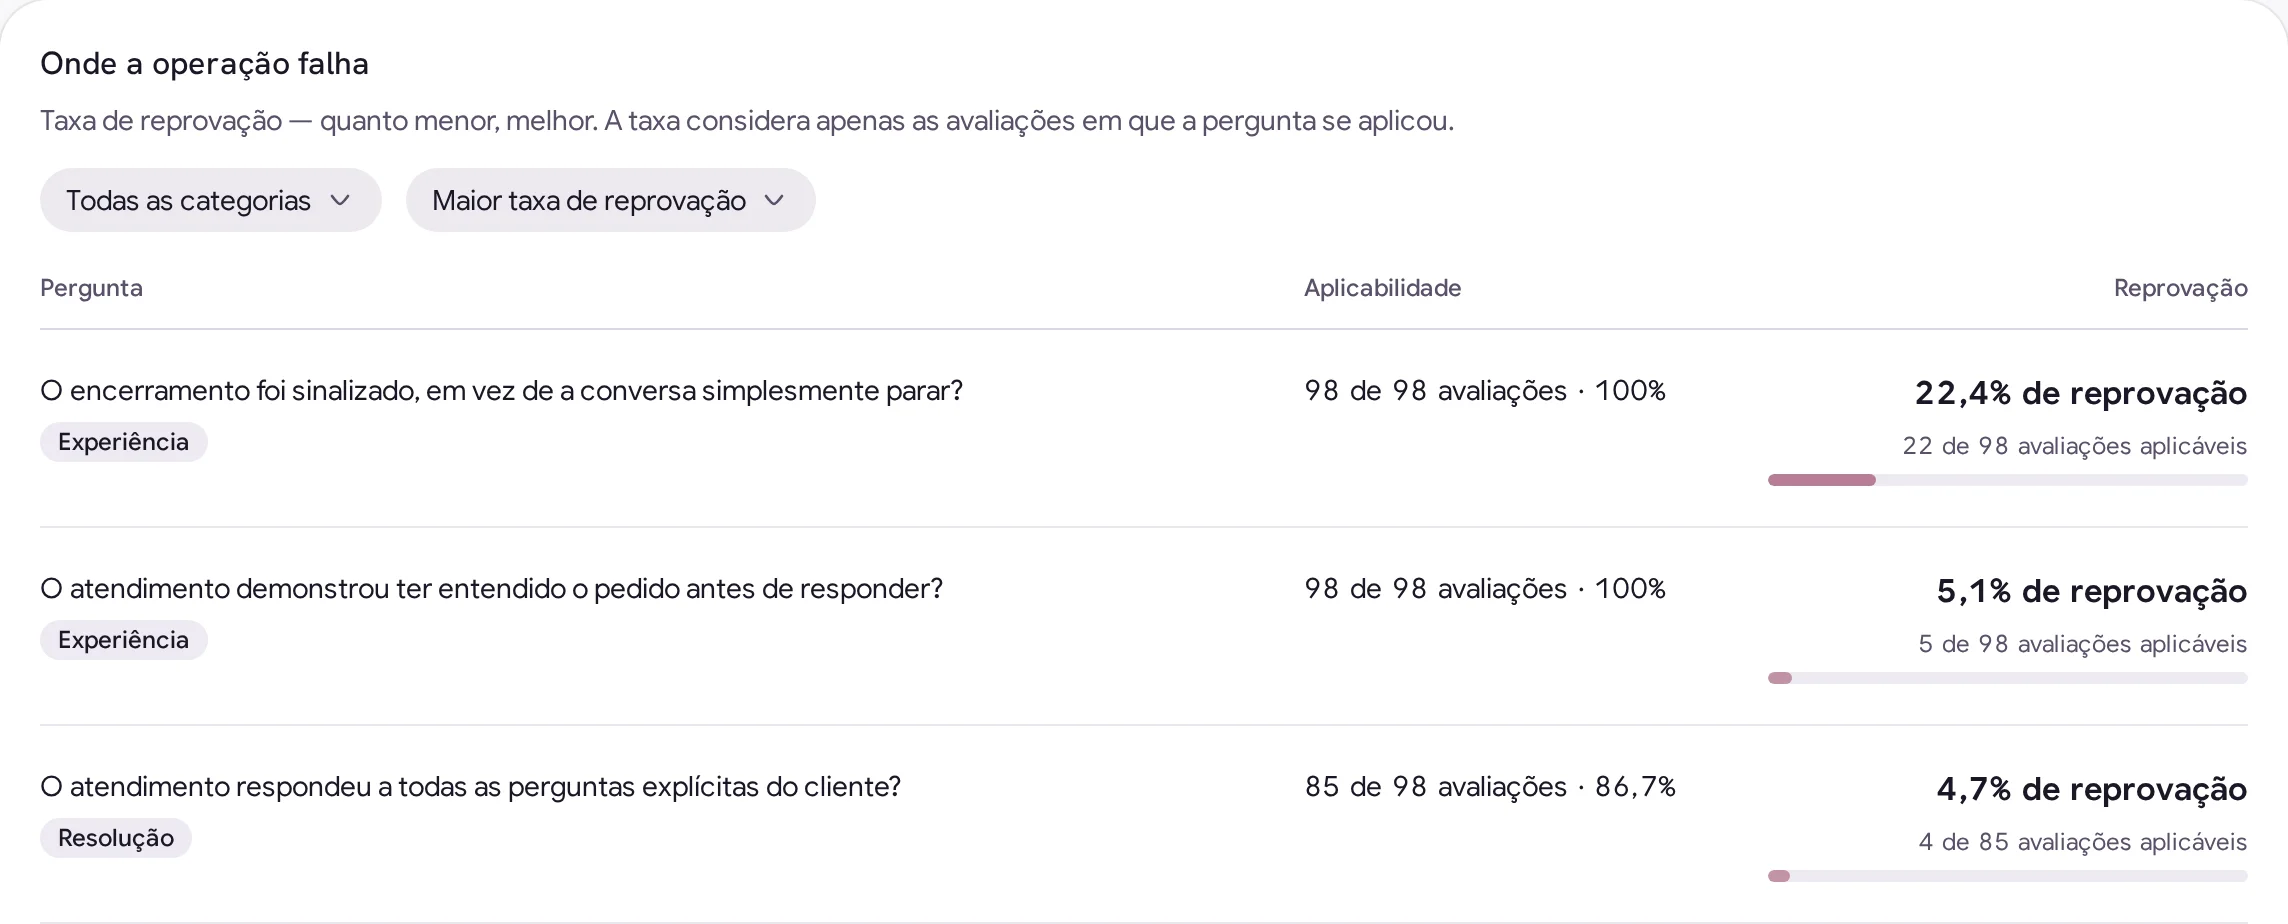
O que muda para a rotina de monitoria:
- Reprovação por pergunta, sobre o volume inteiro. A tela de perguntas mostra quanto cada uma reprova, considerando só as avaliações em que ela se aplicou. É a leitura de processo que a amostra não sustenta.
- Quebras em lista própria. Os tickets com conduta inadequada aparecem separados, em vez de diluídos numa média.
- O motivo ao lado da falha. Os tickets também ganham tópicos, os motivos de contato descobertos no histórico e aprovados pelo time, sem depender das tags (o porquê está em por que as tags do helpdesk não bastam). A falha de conduta e o assunto do contato ficam na mesma ferramenta.
- Satisfação fora da nota. Como o cliente saiu da conversa é uma medida separada, e o CSAT recebido é outra. Nenhuma das duas entra na nota do ticket, e as duas nunca são somadas. A diferença está explicada em análise de sentimento no atendimento.
Quem é Analyst no Echo vê o detalhe dos próprios tickets, o que ajuda a devolutiva: o atendente lê a mesma evidência que o gestor leu. E o Kai, o assistente da plataforma, responde em português sobre a nota do ticket entre dois períodos, com os tickets que sustentam a resposta.
Os limites: o Echo não avalia ticket aberto nem acompanha conversa em tempo real, e não dispensa a pessoa de qualidade. Ele aponta onde olhar; a calibração, a devolutiva e a mudança de procedimento continuam sendo trabalho do time. Antes da análise, identificadores como CPF, e-mail, telefone e cartão viram marcadores, e os detalhes estão aqui.
Um exercício para este mês #
Pegue o formulário de monitoria atual e passe cada pergunta por dois testes. Ela se responde com sim, não ou não se aplica? Duas avaliadoras concordariam lendo o mesmo ticket? Reescreva as que falharem.
Depois, troque o relatório do mês: em vez da média por atendente, monte a taxa de reprovação por pergunta, com o número de avaliações aplicáveis ao lado. Escolha a pergunta que mais reprova no time todo e leve cinco tickets dela para quem é dono do procedimento. É a primeira devolutiva que vai para cima, e não para a fila.