Quem já apresentou um gráfico de “sentimento dos clientes” para a diretoria conhece a pergunta que vem logo depois: de onde saiu esse número? A análise de sentimento no atendimento promete ler o humor de milhares de conversas sem que ninguém precise abrir ticket por ticket. Parte disso funciona. A outra parte esbarra no que a conversa não diz, e é dela que este texto trata.
O que a análise de sentimento com IA faz bem #
Um modelo de linguagem lê texto com muito mais paciência do que qualquer time. Ele percebe quando o cliente agradece de verdade, quando repete a mesma reclamação pela terceira vez, quando a frase “ok, obrigado” fecha um problema resolvido e quando fecha uma desistência. Em volume, isso dá uma leitura que a amostragem manual nunca vai dar: a de todo o atendimento, e não de vinte tickets escolhidos na sexta à tarde.
Também funciona bem para achar extremos. O cliente que escreve “terceira vez que explico isso” e, duas mensagens depois, pede o protocolo para abrir reclamação na Anatel não deixa dúvida. Aí basta ler tudo, coisa que ninguém do time tem tempo de fazer.
O problema começa quando esses acertos viram uma porcentagem no dashboard e todo mundo passa a tratar o número como se fosse medição.
Inferir satisfação e medir satisfação são coisas diferentes #
CSAT é o cliente respondendo a uma pergunta. Tem o viés de quem se dá ao trabalho de responder, mas é a voz dele. Satisfação inferida é um modelo olhando as reações do cliente na conversa e estimando como ele saiu. (Discutimos o CSAT e os outros números da operação em indicadores de atendimento.)
Cada uma erra de um jeito. Por isso desconfiamos de ferramenta que junta as duas num “índice de satisfação” só. Quando o número cai, você não sabe se foi a pesquisa ou o modelo lendo de outro jeito as conversas de um tópico novo.
Algumas situações em que a inferência tropeça, e que qualquer supervisor reconhece:
- Ironia e cansaço. “Perfeito, mais uma semana sem internet” tem palavras positivas e nenhuma satisfação. Um bom modelo acerta muitos desses casos. Alguns vão escapar, e você só descobre quais abrindo tickets.
- O cliente educado que já decidiu sair. Ele agradece, elogia a atendente e cancela no mês seguinte. A conversa sai com cara de satisfeita e o cliente vai embora do mesmo jeito. É o caso que mais aparece quando se compara pesquisa com a voz do cliente nos tickets.
- Satisfação com o atendente, insatisfação com a empresa. O agente resolveu o que dava, a política é que era ruim. Uma leitura de sentimento sozinha junta as duas coisas.
- Resolução que acontece fora do ticket. O problema foi resolvido por telefone ou numa visita técnica, e a conversa escrita termina sem nenhuma reação.
A inferência continua útil, desde que fique ao lado do CSAT, com nome próprio, e nunca somada a ele.
Onde as duas discordam está a pauta #
O mais útil é olhar as duas medidas no mesmo ticket. CSAT ruim com uma conversa que termina em agradecimento costuma apontar para política ou produto, não para o atendente. CSAT bom com uma conversa fria, seca, cheia de “ok”, pode ser o cliente educado que já decidiu sair. Vale separar esses tickets toda semana e ler um por um. São poucos.
Quando o ticket não tem sinal suficiente #
Existe um tipo de ticket que toda fila tem aos montes: o cliente pergunta, o agente responde, e o cliente some. Não agradece, não reclama, não responde mais.
Não dá para dizer qual foi o sentimento dele. Muita ferramenta classifica isso como neutro, e aí o gráfico ganha uma faixa cinza enorme que parece dizer alguma coisa sobre o cliente, quando só diz que ele não escreveu. Neutro é uma reação. Silêncio é ausência de dado. Tratar um como o outro engorda o denominador e dilui qualquer tendência.
O mínimo que se deve esperar de uma análise séria é separar o que foi avaliado, o que não tinha sinal para avaliar e o que ainda não foi analisado. Se o fornecedor não consegue te dizer quantos tickets ficaram sem sinal, desconfie da porcentagem que ele mostra.
O volume sem sinal também diz alguma coisa. Muito ticket sem sinal num tópico pode ser resolução no primeiro contato ou abandono, e só abrindo alguns você descobre qual.
O cruzamento mostra onde olhar, não quem é o culpado #
O relatório mostra que a insatisfação subiu no mesmo mês em que entrou um atendente novo, ou em que o tópico de “atraso na entrega” cresceu. A tentação é ligar uma coisa à outra e sair da sala com um culpado.
Só que o atendente novo pode ter pego justamente a fila de casos mais difíceis. O cruzamento aponta o lugar. Ele não diz o que causou o quê, nem prevê quem vai cancelar.
Outra armadilha é a amostra pequena. Oito respostas de CSAT num mês e seis no outro produzem variações enormes em pontos percentuais, que não significam nada. Qualquer destaque automático deveria exigir um mínimo de respostas antes de aparecer na tela, e esse mínimo deveria estar escrito ali, à vista de quem lê.
Como o Echo trata sentimento e satisfação #
Foi com essas limitações na cabeça que a análise de satisfação do Módulo Echo, da plataforma Kairos, foi desenhada. O Echo lê atendimentos finalizados vindos do helpdesk e, para cada ticket, estima como o cliente saiu da conversa a partir das reações dele. Antes de ler qualquer conversa, ele troca identificadores como CPF, telefone e e-mail por marcadores; a seção de privacidade explica o que é substituído e o que fica.
Ele não dá nota de sentimento por mensagem nem acompanha conversa aberta. Se você procura alerta em tempo real para priorizar a fila, não é isso.
Essa satisfação inferida não entra na nota do ticket, que é somada de perguntas de resposta fechada sobre Resolução, Experiência e Conduta, nem é somada ao CSAT recebido. As duas aparecem como medidas distintas, com filtros por período, fonte e canal e comparação com o período anterior.
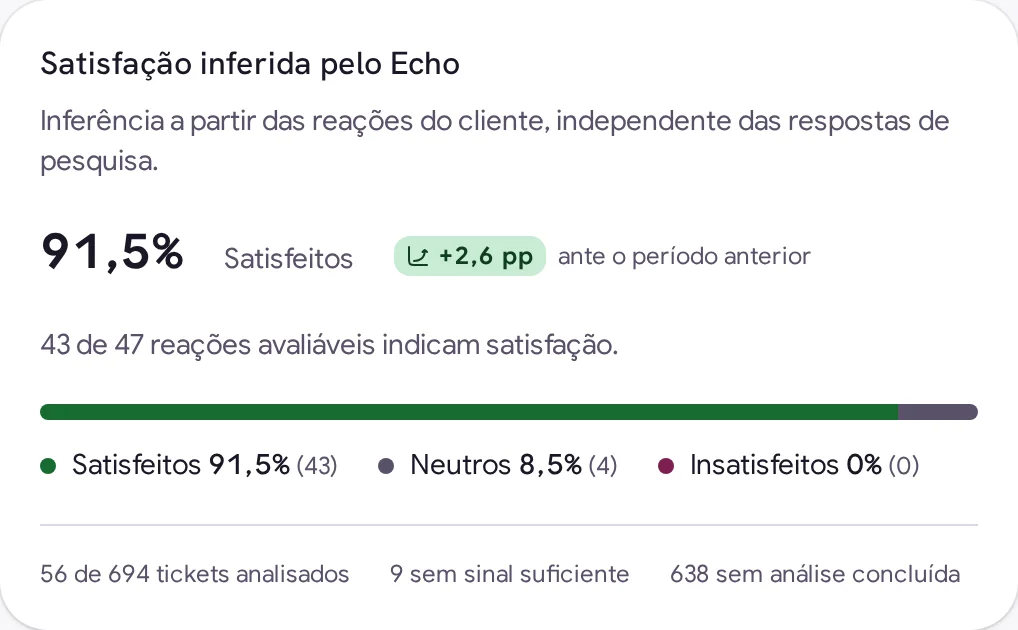
Repare na conta. Os 91,5% saem de 47 reações avaliáveis, num período com 694 tickets. Os 9 sem sinal e os 638 ainda sem análise concluída ficam fora da porcentagem, contados no rodapé. Sem essa linha, o 91,5% pareceria falar do período inteiro.
No detalhe do ticket, o gestor pode corrigir as respostas da avaliação quando discorda do Echo, e a correção sobrevive a um reprocessamento. Sem isso, cada reprocessamento apagaria o trabalho de revisão.
A Leitura do Echo fala de CSAT, com cuidado #
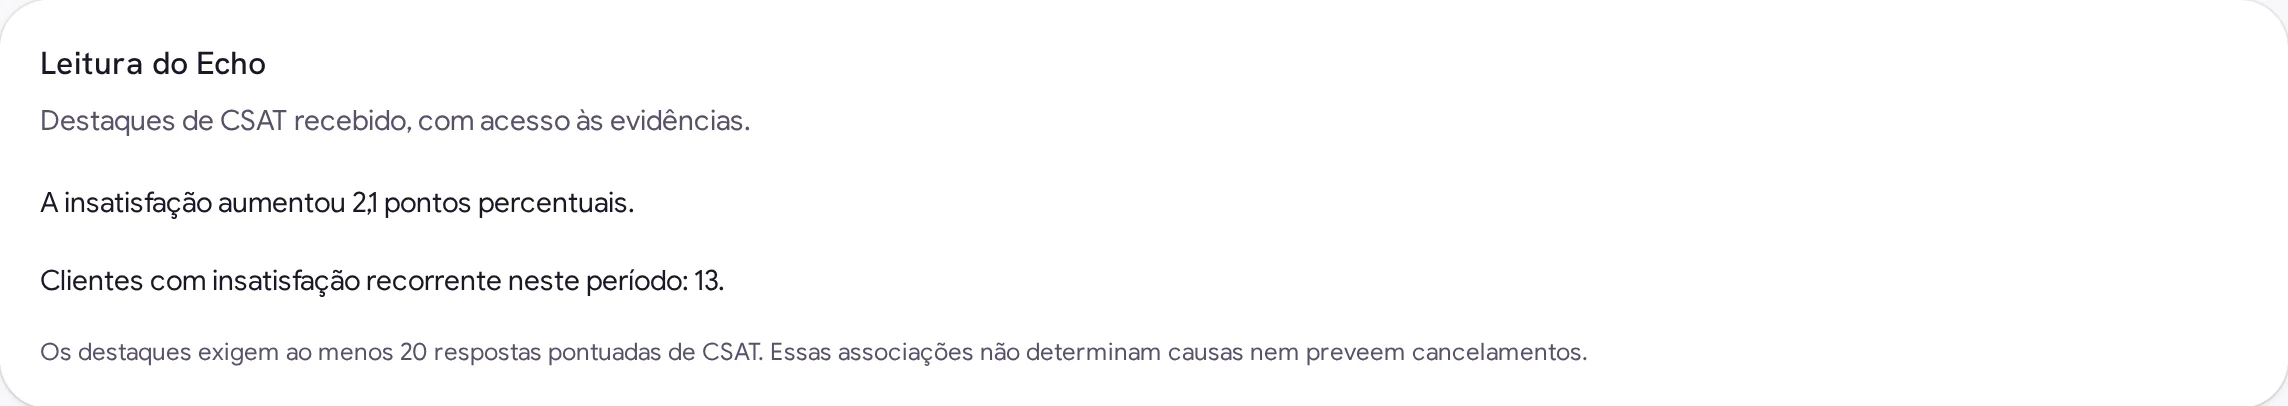
Para o CSAT recebido, a Leitura do Echo traz destaques do período com acesso às evidências, ou seja, os tickets por trás de cada frase. Os destaques só aparecem a partir de 20 respostas pontuadas, e a própria tela avisa que as associações não determinam causas nem preveem cancelamentos.
O CSAT é atribuído aos atendentes que escreveram no ticket. A regra é simples: um ticket difícil que passou por três pessoas conta para as três. Leia o ranking de atendentes com isso em mente.
O que perguntar antes de confiar num número de sentimento #
Seja qual for a ferramenta, faça estas perguntas antes de levar o indicador para a diretoria:
- O número é CSAT, é inferido ou é uma mistura dos dois?
- Quantos tickets ficaram sem sinal, e eles estão dentro ou fora da porcentagem?
- Qual é a amostra mínima para um destaque aparecer?
- Dá para abrir os tickets que sustentam cada afirmação?
- Se o time corrigir uma leitura errada, a correção fica ou some no próximo processamento?
Se as respostas forem vagas, não leve o número para a diretoria.
Depois, faça um teste. Pegue 30 tickets do mês, leia você mesmo e anote como cada cliente saiu. Depois compare com o que a ferramenta disse. Se vocês discordarem em muitos, ninguém precisa te mostrar benchmark. E, quando for para o slide, coloque os dois números em linhas separadas, cada um com a sua base: quantas respostas de pesquisa, quantas reações avaliáveis.
Uma coisa a análise de sentimento não faz: dizer por que o cliente entrou em contato. Para isso você precisa dos motivos de contato bem classificados. Satisfação caindo em “segunda via de boleto” é uma pauta. Satisfação caindo no geral não é pauta de nada.