Quase todo painel de indicadores de atendimento ao cliente tem os mesmos cinco números: TMA, TME, FCR, CSAT e NPS. Eles dizem se a fila anda e como o cliente saiu da conversa. O que nenhum deles diz é por que tanta gente precisou falar com a empresa.
Na reunião de resultado do trimestre, o TMA caiu, o CSAT subiu meio ponto, e o diretor financeiro pergunta por que o volume de tickets cresceu tanto. O painel não tem essa resposta.
Os indicadores de atendimento ao cliente mais usados #
TMA: tempo médio de atendimento #
TMA = tempo total de atendimento ÷ número de atendimentos.
Em telefone, soma conversa, espera em linha e o trabalho depois da ligação. Em chat e e-mail cada ferramenta conta de um jeito, então descubra qual é a sua antes de comparar com número de mercado.
Serve para dimensionar equipe. Como meta individual, ensina o agente a encerrar a conversa antes de resolver, e o cliente volta dois dias depois.
TME: tempo médio de espera #
TME = tempo total em fila ÷ número de atendimentos. É o primeiro número a estourar quando o volume sobe sem aviso, e quando isso acontece raramente o problema é a equipe estar devagar. Costuma ser escala mal feita, pico sazonal ou, mais vezes do que se admite, um defeito do produto que gerou uma leva de contatos iguais.
FCR: resolução no primeiro contato #
FCR = casos resolvidos sem recontato dentro da janela ÷ total de casos. A janela costuma ser de alguns dias, e recontato é qualquer ticket novo do mesmo cliente nesse prazo.
O difícil é contar direito. O cliente que abre três tickets sobre a mesma entrega atrasada, um no WhatsApp, um por e-mail e outro no chat, costuma escapar da conta quando o helpdesk não junta a identidade dele entre os canais. E o inverso também acontece: o cliente que volta na semana seguinte com outra dúvida derruba o FCR sem que o primeiro caso tenha ficado mal resolvido. Vale o esforço: cada recontato é um ticket a mais na fila e um cliente mais irritado.
CSAT: satisfação com o atendimento #
Pergunta curta ao fim do atendimento, de 1 a 5. CSAT = respostas com nota 4 ou 5 ÷ total de respostas. Tem dois vieses conhecidos: responde quem quer, e quem está muito satisfeito ou muito irritado responde mais. E um CSAT baixo pode ser culpa do agente ou de um defeito que ninguém no atendimento tinha como consertar.
NPS: probabilidade de recomendar #
Criado por Fred Reichheld, da Bain, pergunta de 0 a 10 a chance de o cliente recomendar a empresa: 9 e 10 são promotores, 7 e 8 neutros, 0 a 6 detratores, e a nota é a porcentagem de promotores menos a de detratores (a definição está no site da Bain).
O NPS foi pensado para medir a relação com a marca. Muita operação dispara depois do ticket, e aí a nota do suporte carrega o preço, a entrega e o produto: o cliente pode adorar o atendente e detestar a mensalidade.
Outros que costumam aparecer #
Muitos painéis trazem ainda o tempo de primeira resposta, que é diferente do tempo até a resolução (um ticket respondido em cinco minutos pode ficar três dias aberto), o SLA cumprido, o backlog do fim do dia e o CES, que mede o esforço do cliente para resolver o problema (quando usar cada pesquisa está em pesquisa de satisfação: NPS, CSAT e CES). Eles têm a mesma limitação dos cinco de cima.
O ponto cego do painel #
Os indicadores clássicos olham para a conversa depois que ela começou. Nenhum conta por que ela começou, e é essa a pergunta que a diretoria faz quando o volume sobe.
Pense num mês em que o TME dobrou. Dá para contratar ou mexer na escala. Ou dá para descobrir que metade do aumento veio de um assunto só: uma mudança na tela de pagamento deixou o QR Code do Pix falhando para parte dos clientes. No primeiro caminho você paga para absorver o problema. No segundo, alguém do produto corrige uma tela e o volume volta ao normal.
Volume por motivo de contato: o indicador que falta #
É contar quantos tickets chegaram por cada motivo (cobrança indevida, nota fiscal, cancelamento, conexão) e acompanhar esse número mês a mês. Como montar a lista está em motivos de contato.
Imagine que você já tem a lista. O número de um mês sozinho diz pouco. Saber que “cobrança” é o maior motivo não muda nada. Saber que “cobrança em duplicidade” triplicou desde a troca do gateway te dá alguém para cobrar na reunião com o financeiro.
Volume bruto engana, use taxa de contato #
O financeiro derruba o volume bruto em um minuto. Se a base de clientes cresceu 20% no trimestre, o volume de quase todo motivo sobe junto sem que nada tenha piorado. O número que aguenta a reunião é a taxa: tickets do motivo divididos por clientes ativos, pedidos ou transações do período, algo como “cobrança em duplicidade por mil pagamentos”.
Outra armadilha é o cliente que reclama da fatura e, no mesmo ticket, pede o cancelamento. Se ele contar nos dois motivos, a soma passa do total de tickets. Para comparar volume, fique com um motivo principal por ticket.
Por que quase ninguém tem esse número confiável #
Porque ele costuma vir das tags do helpdesk, e tag é marcada no meio do atendimento, por pessoas diferentes, cada uma com seu critério. Parte dos tickets fica sem tag. Alguém renomeia uma tag em maio e abril deixa de ser comparável. Quem usa Zendesk vê isso nos relatórios por tag; o resto está em por que as tags do helpdesk não bastam.
Para a tendência valer, o motivo precisa cobrir a maior parte dos tickets e manter o mesmo critério ao longo do tempo. A tag não garante nenhuma das duas coisas.
Como o Echo trata o volume por motivo #
O Módulo Echo, da plataforma Kairos, foi feito para esse número. Ele lê os atendimentos finalizados do seu helpdesk e organiza o volume em tópicos descobertos no histórico da sua operação.
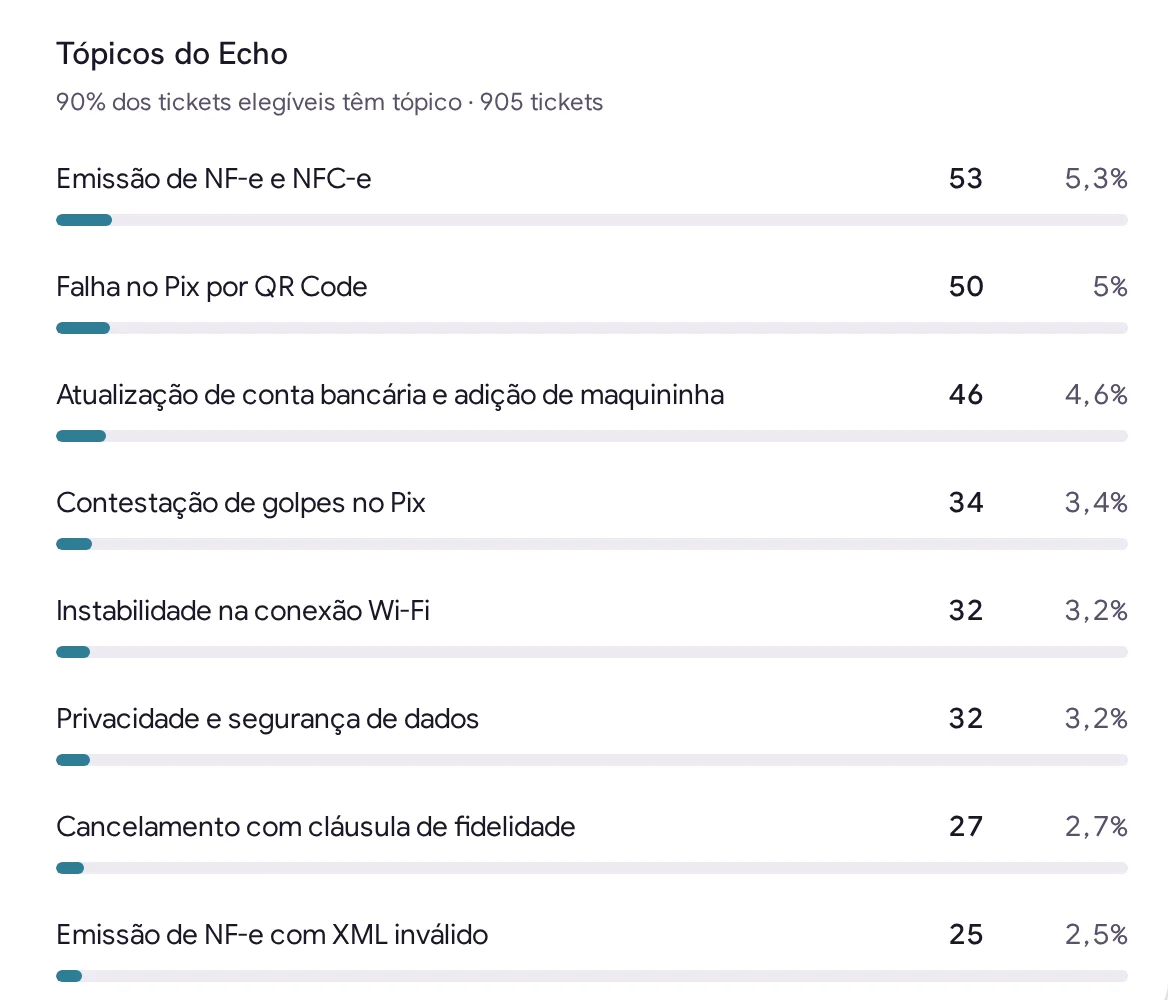
Cada tópico chega como proposta, com volume e tickets de exemplo, e só entra depois que alguém do time aprova. Os tickets de referência aprovados fixam o critério de classificação, e reajustá-lo é decisão humana que vale para os tickets novos sem reescrever o passado. Março e julho continuam comparáveis. Cada ticket pode ter vários tópicos e um primário; some pelo primário quando for comparar volume.
Os tickets que não se encaixam em nenhum tópico alimentam propostas de tópicos novos. Um defeito que começou numa terça-feira tem chance de aparecer como proposta nas semanas seguintes, antes de virar o maior motivo do mês.
A classificação automática também erra, e tópico novo com poucos tickets oscila muito. Quando o time discorda de um tópico, pode reajustar o critério ou revogá-lo, e os tickets dele voltam para os não classificados.
O CSAT que o cliente respondeu e a satisfação que a análise infere da conversa (tema do post sobre análise de sentimento no atendimento) ficam separados e nunca são somados. Os destaques de CSAT da Leitura do Echo pedem um mínimo de respostas antes de aparecer e lembram que associação não é causa.
Antes de qualquer análise, identificadores como CPF, e-mail e telefone são trocados por marcadores. Os detalhes estão em privacidade no Echo.
O que muda na reunião de resultados #
TMA, TME, FCR, CSAT e NPS continuam no painel, e o TMA continua sendo o que dimensiona equipe. O que muda é por onde a reunião começa.
Comece pelos motivos que mais cresceram no período, que nem sempre são os maiores. Toda semana, olhe a taxa dos motivos que mais subiram e marque no gráfico as datas em que algo mudou (um release, a troca do gateway, uma campanha). Quando um motivo sobe, a pergunta útil é quem precisa corrigir aquilo. Às vezes é o próprio atendimento, com uma base de conhecimento desatualizada. Muitas vezes é produto ou financeiro (mais sobre isso em análise de atendimento ao cliente).
Isso gera atrito. O produto não gosta de ouvir que a tela nova gerou 400 tickets, e alguém vai questionar a classificação. Leve os tickets de exemplo junto com o número. Sem eles, a discussão vira opinião contra opinião.